在2026年OpenComputeProject(OCP)全球峰会上,Meta正在分享下一代开放网络基础设施,其中包括:
-我们首款液冷网络机柜(IcePack)及102.4T交换平台(IceCube)
-扁平化平面网络架构(FlattenedPlanarFabric,FPF)——一种从根本上改变GPU与网络连接方式的多平面后端scale-out网络
-MetaRoCE——我们的开源AI传输协议
-在OCP内发起开放交换平台架构(OpenSwitchPlatformArchitecture,OSPA)倡议
我们诚邀工程师、芯片厂商、系统集成商与运营商,与我们及OCP社区携手应对构建开放、高效、可持续AI基础设施的挑战。
在Meta,我们坚信开放网络是构建高性能、可扩展且可持续基础设施的关键,自2011年联合创立OCP以来,我们始终践行这一信念。
在持续演进的AI变革中,Meta不断突破数据中心网络的边界,并将我们的进展分享给整个行业。在OCP2025大会上,我们发布了最新的AIscale-out网络,并推动了"以太网扩展网络"(EthernetforScale-UpNetworking,ESUN)倡议的创立。
今年在OCP2026,我们分享的网络创新直接支撑着我们最新的AI工作负载,例如Meta的MuseWonder与MuseSpark模型,以及为每个人打造的个人AI助理Muse。以下是部分亮点:
-102.4Tscale-out交换机:Meta首款液冷网络机柜(IcePack)与102.4T交换板(IceCube),旨在支持高功率密度、提供更高散热效率,并支撑吉瓦级(GW)规模的AI集群。
-Scale-out扁平化平面网络架构(FPF):Meta的多平面网络架构,以更低时延构建更大、更高效的GPU集群——相关经验已与我们的云合作伙伴分享。
-面向多站点集群的Scale-across:Meta拍比特级后端聚合(BAG)超级核心层,以及超大规模训练任务如何应对这一规模下的故障——同时概述我们如何基于FBOSS与SAI构建SRv6区域骨干网,以覆盖更远的距离。
-面向Scale-Up的以太网(ESUN):Meta的MTIA300系统采用基于以太网的51.2Tscale-up交换机Tahan,为每个加速器提供6.4Tbps带宽——并预览基于102.4T芯片、每机柜72个加速器的下一代设计,未来芯片将向基于ESUN的实现演进。
-开放交换平台架构(OSPA):由Meta、微软与阿里巴巴共同牵头的新OCP倡议,旨在标准化交换机平台层——规范v1.0已提交至OCP。
-MetaRoCE:Meta面向AI网络的RDMA传输协议——现已提供开源实现。
102.4T下一代:AI规模下的液冷网络
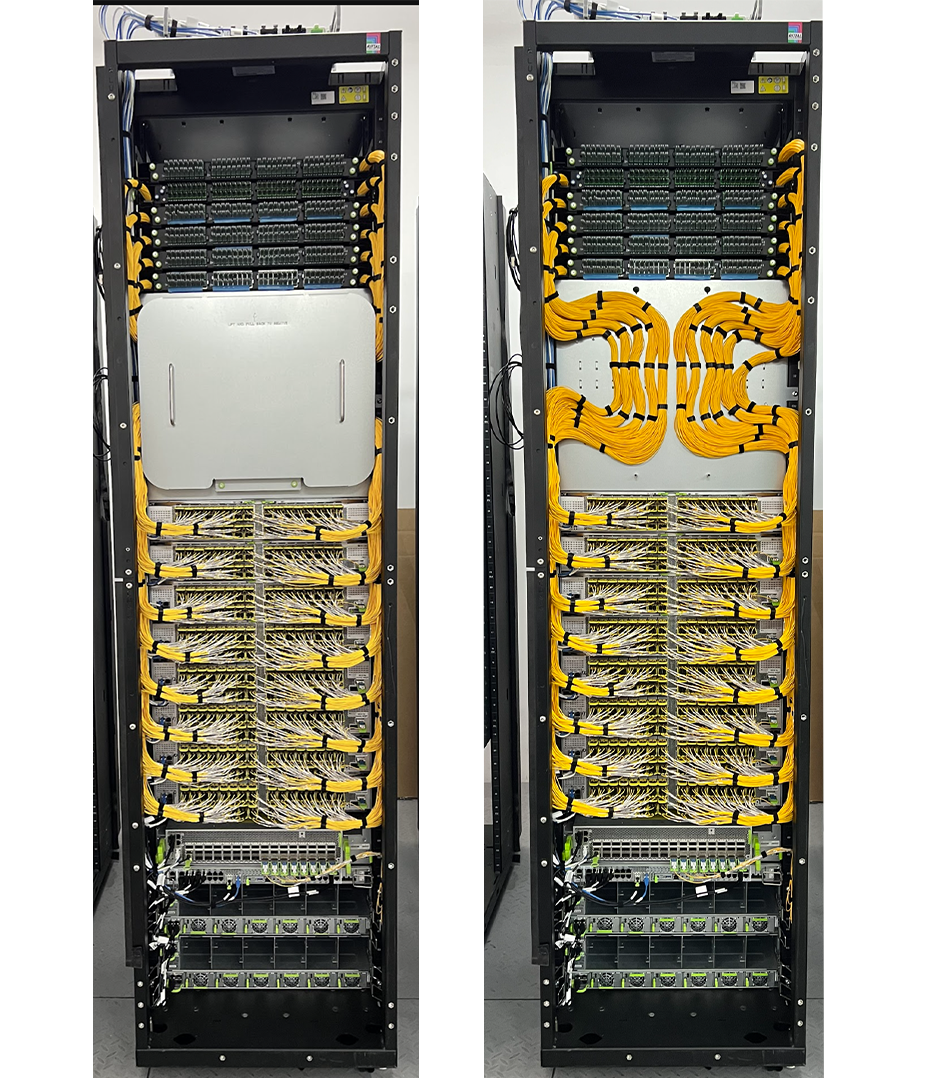
随着AI集群扩展到吉瓦级,网络交换机必须在日益严苛的供电与散热约束下提供大幅增长的带宽。我们的答案是**IcePack**机柜——Meta首代液冷网络机柜。
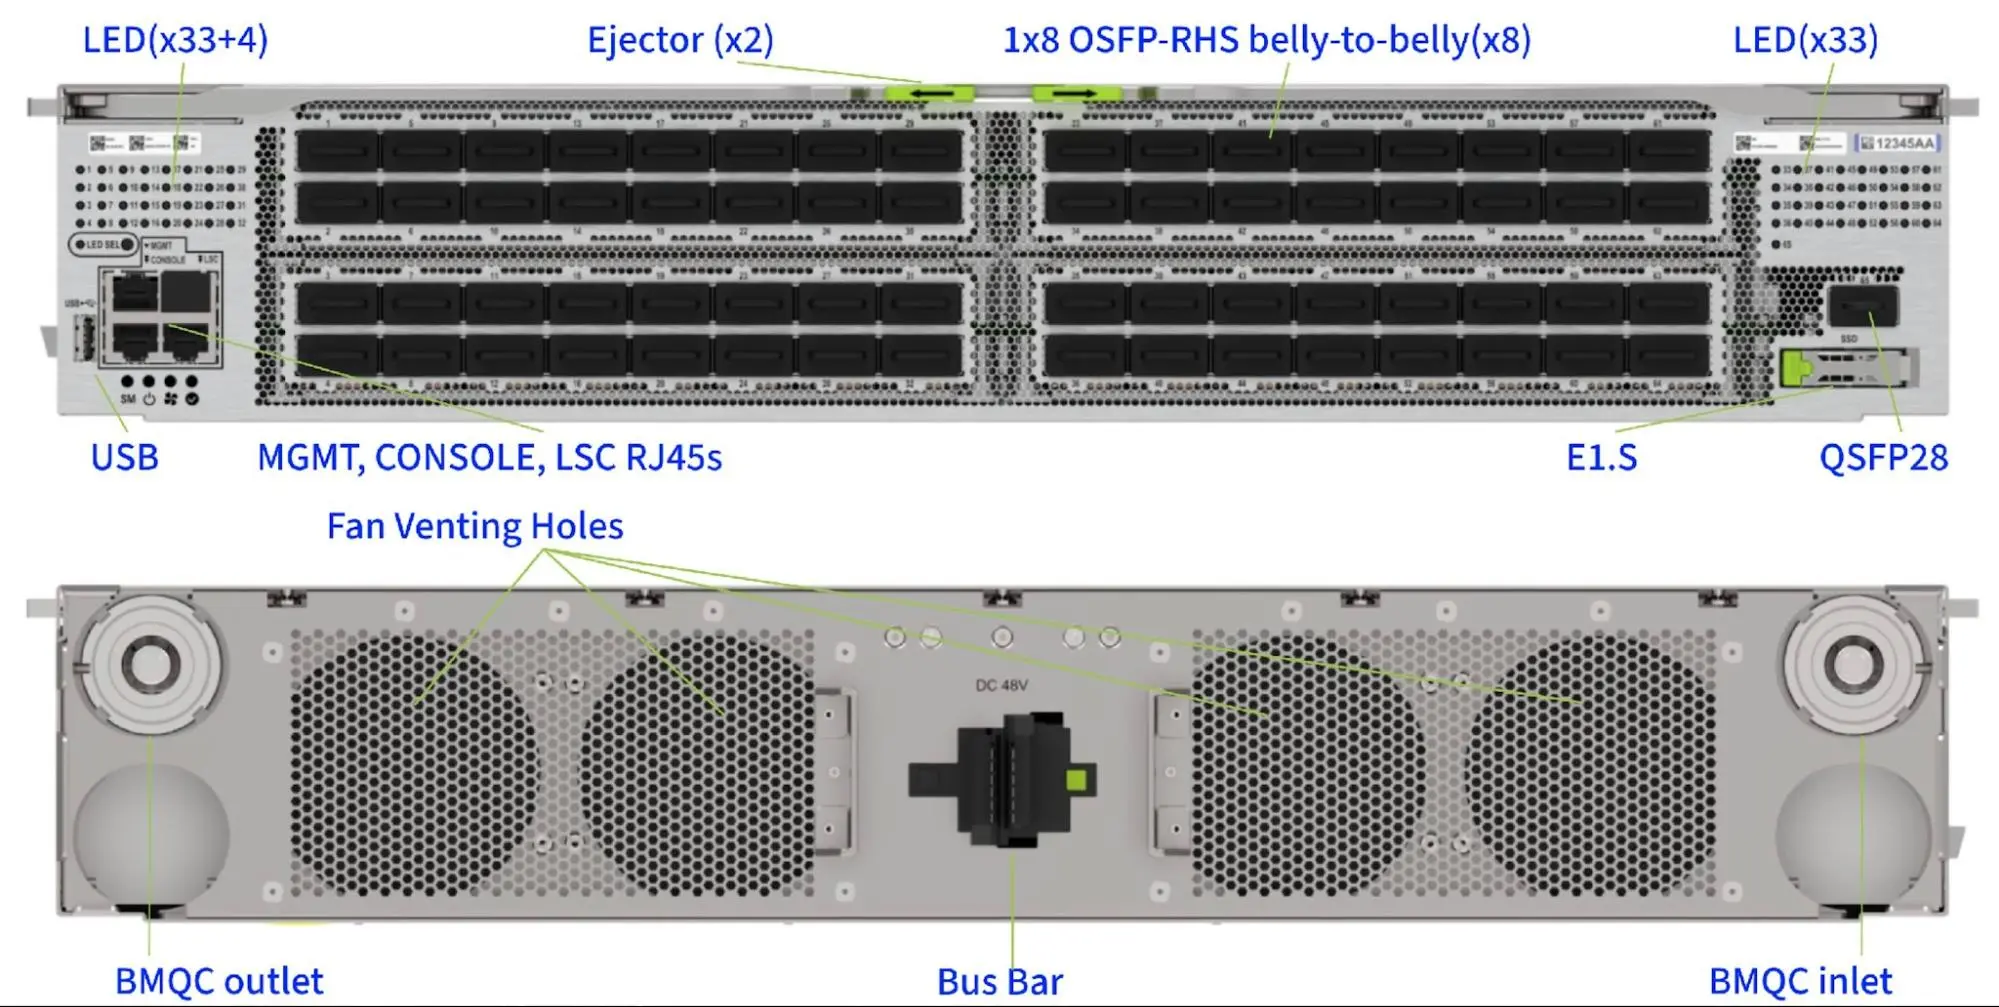
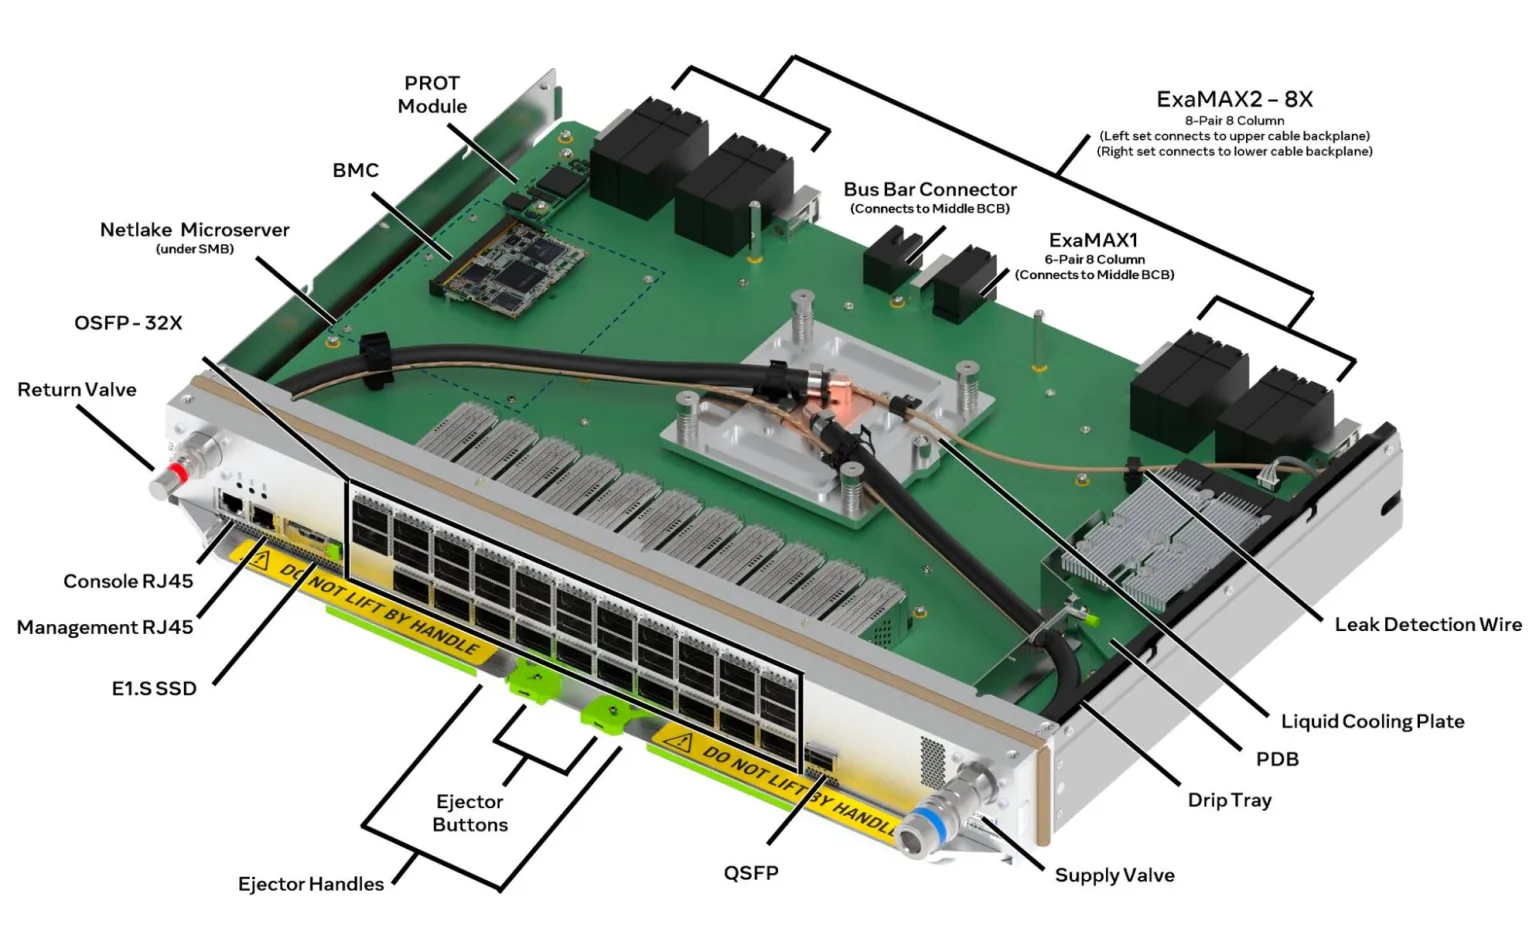
IcePack基于OCP的ORV3-HPRv1机柜标准。**IceCube**交换板——提供128×800G无阻塞交换能力的102.4T(Tbps)网络交换机——安装于每个机柜中。IceCube提供**两个版本**,一个基于Broadcom的**Tomahawk6C**交换ASIC,另一个基于NVIDIA的**Spectrum-6**交换ASIC。两者均运行Meta的开源网络操作系统**FBOSS**,并利用OCPSAI(交换机抽象接口)。
相较我们的51.2T平台,这一新一代产品带宽翻倍,同时达到了下一代AI数据中心所需的热密度。
IcePack机架-Meta的第一个液冷网络机架,配备IceCube102T交换机刀片。
IceCube-Meta的102.4Tbps液冷交换刀片,提供128×800G无阻塞容量和运行FBOSS。
AI网络的扩展:从楼宇到区域
正如在Meta及整个行业所见,AI集群如今已横跨多栋楼宇、多个园区乃至多个区域。这要求网络架构不仅要规模庞大,还要具备韧性与灵活性。
###扁平化平面网络架构(FPF):更具韧性、更大规模的集群
我们正式推出扁平化平面网络架构(FlattenedPlanarFabric,FPF)——Meta的多平面后端scale-out网络,它从根本上改变了GPU与网络的连接方式以及网络的控制平面。
在FPF中,每个GPU通过八条独立的100G链路连接到八台不同的交换机(每个网络平面一台)。这种多平面方式取代了传统的单平面上行架构,并带来四大关键优势:
-相比单平面拓扑,可支持更大的无阻塞GPU集群**,从而满足我们最大规模AI训练工作负载所需的扩展能力
-扁平化拓扑:从NSF网络的三层Clos架构演进为两层Clos架构。减少一层交换机降低了网络跳数、时延与基础设施成本。
-网卡级硬件负载均衡:传统上由网络交换机完成的负载均衡,现在从网卡(NIC)开始——网卡以硬件方式将每个数据包散布(spray)到全部八个平面。
-交换机与主机相结合的容错控制平面:FPF的控制平面同时涵盖交换机与主机,使主机能够将流量从故障平面引导开。
Meta与NVIDIA密切合作,在Meta基础设施内开发FPF,借助NVIDIASpectrum-X多平面创新,确保FPF在各种故障场景与运维生命周期下依然保持高性能。Beyond我们自身的基础设施,Meta与NVIDIA还一直与双方共同的云合作伙伴紧密协作,基于FPF的经验帮助这些伙伴在其环境内实现多平面网络的标准化。
###打通自有数据中心与公有云
与云厂商在FPF上的合作只是一个例证——在Meta,我们不仅建设自己的基础设施,也在帮助合作伙伴构建他们的基础设施。
仅靠自建数据中心无法满足我们扩展AI算力的雄心,因为数据中心建设以"年"为周期,而需求以"月"为周期变化。因此,我们在自有园区之外,还使用租赁设施与**公有云算力**来弥合差距。但前提是:无论GPU位于何处,网络的行为都必须完全一致。
这确实非常困难,因为云网络与自有机柜并不相同。各家云厂商的网络拓扑各不相同,而非遵循统一设计;缓冲往往更浅,拥塞与丢包行为随之改变;RDMA传输因厂商而异,一些云仍在运行InfiniBand而非以太网与RoCE;在少量云实例上可行的方案,在集群规模下往往就会失效。
在OCP,我们分享了如何将这些环境收敛为统一的运营模型。其中包括**标准化的性能验证框架**——云合作伙伴在集群交付之前,运行统一的点对点与集合通信基准测试套件,规模从数十个GPU到一千多个,性能是被验证出来的,而非假设出来的。还包括**异构多平面网络的规范化**——将各异的流量等级方案与拥塞控制参数映射到我们的无损RDMA等级上,使端到端路径在不同厂商的网卡与交换机之间表现可预期。
我们始终坚持的原则是:异构是可管理的,但只有标准化才能让成本可控。测试与认证、RDMA传输与拥塞行为、遥测等在各厂商之间仍有差异,而每一处差异都意味着额外的工程投入。
###BAG:Scale-Across聚合层
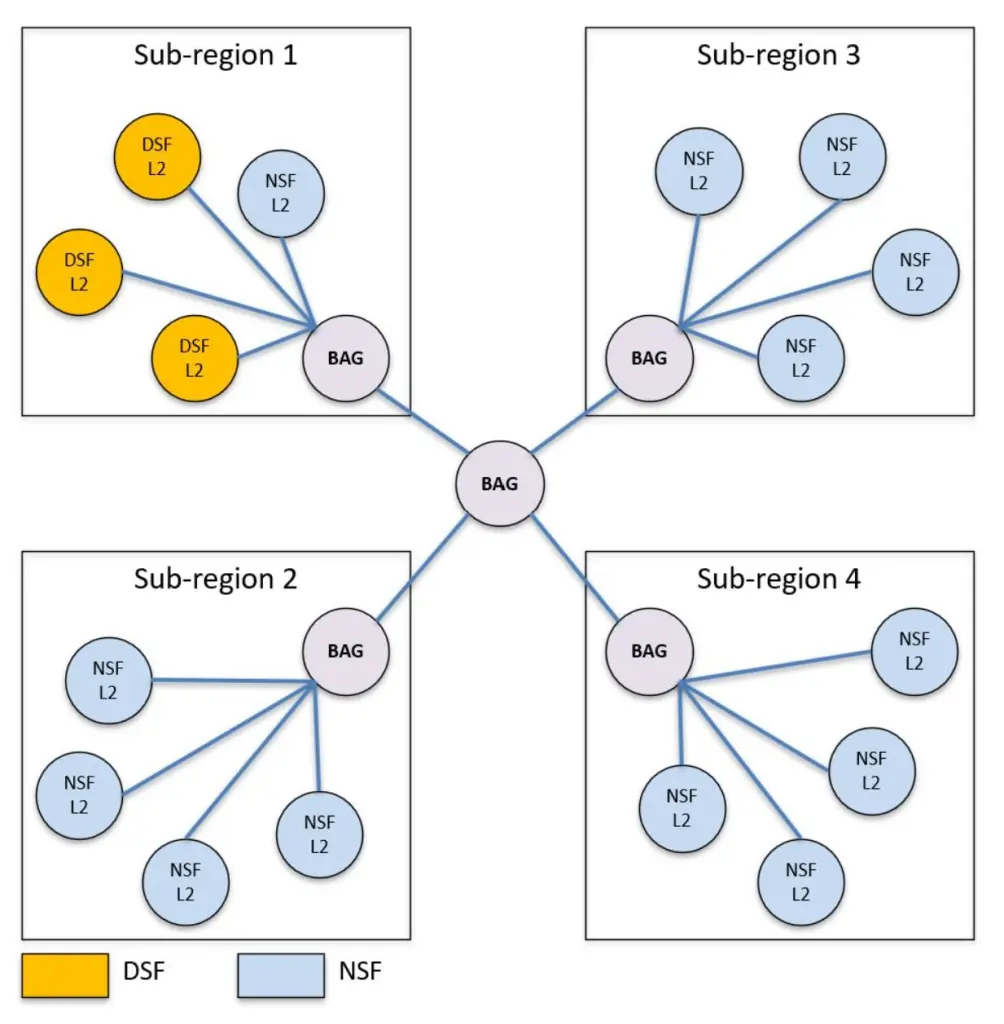
Meta本十年承诺的AI算力规模——Prometheus约1GW(2026年)、Hyperion向5GW扩展——意味着单一集群的增长已超出任何单一区域的承载能力。我们的后端聚合(BackendAggregation,BAG)是一个集中式、基于以太网的超级核心(super-spine),将多个核心层网络互联为一个横跨楼宇、园区与区域的巨型集群。其运行规模达到拍比特级——两个区域之间的BAG互联容量可达每秒数十拍比特。正是BAG使Prometheus得以作为单一集群运行,尽管其算力分散于常规数据中心楼宇、耐候型户外建筑以及相邻的托管机房。
在这样的跨度下,距离本身就成了设计约束。无损以太网所需的缓冲余量与线缆长度成正比,因此当链路延伸到数十公里时,缓冲区管理就从调优细节变为一阶问题。一旦处理失当,拥塞可能远远扩散到引发它的那条链路之外。FBOSS不再按最坏距离为每条链路预留余量,而是**在线测量实际线缆长度**——在无拥塞队列上对探测流量计时以推算往返距离,并据此分配缓冲余量。
负载均衡还必须应对"性能劣化而非完全中断"的路径。BAG使用eBGP链路带宽信令,使流量按每条路径实际可用容量成比例分布,并有意引入阻尼机制,避免单条链路故障将路由震荡扩散到整个域。此外,由于网络间的时延是网络内部时延的数倍,集合通信库——通常在完全感知不到网络距离的情况下选择算法——可能遭遇性能悬崖。
我们正从两个方向着手解决:通过自适应路由优化来降低时延代价,以及通过调度尽量减少需要跨越BAG层的集合通信流量。训练过程全程保持韧性:当某个副本(replica)故障时,它会被自动隔离,其余副本继续跨BAG同步。
未来的方向是更远的距离——跨越数十、数百乃至数千公里的区域间训练任务——以及越来越多混合不同硬件世代与厂商的异构集群。
后端聚合(BAG)将建筑规模的AI结构(DSF和NSF)连接到一个统一的训练网络中,跨子区域。
###基于FBOSS的SRv6区域骨干网
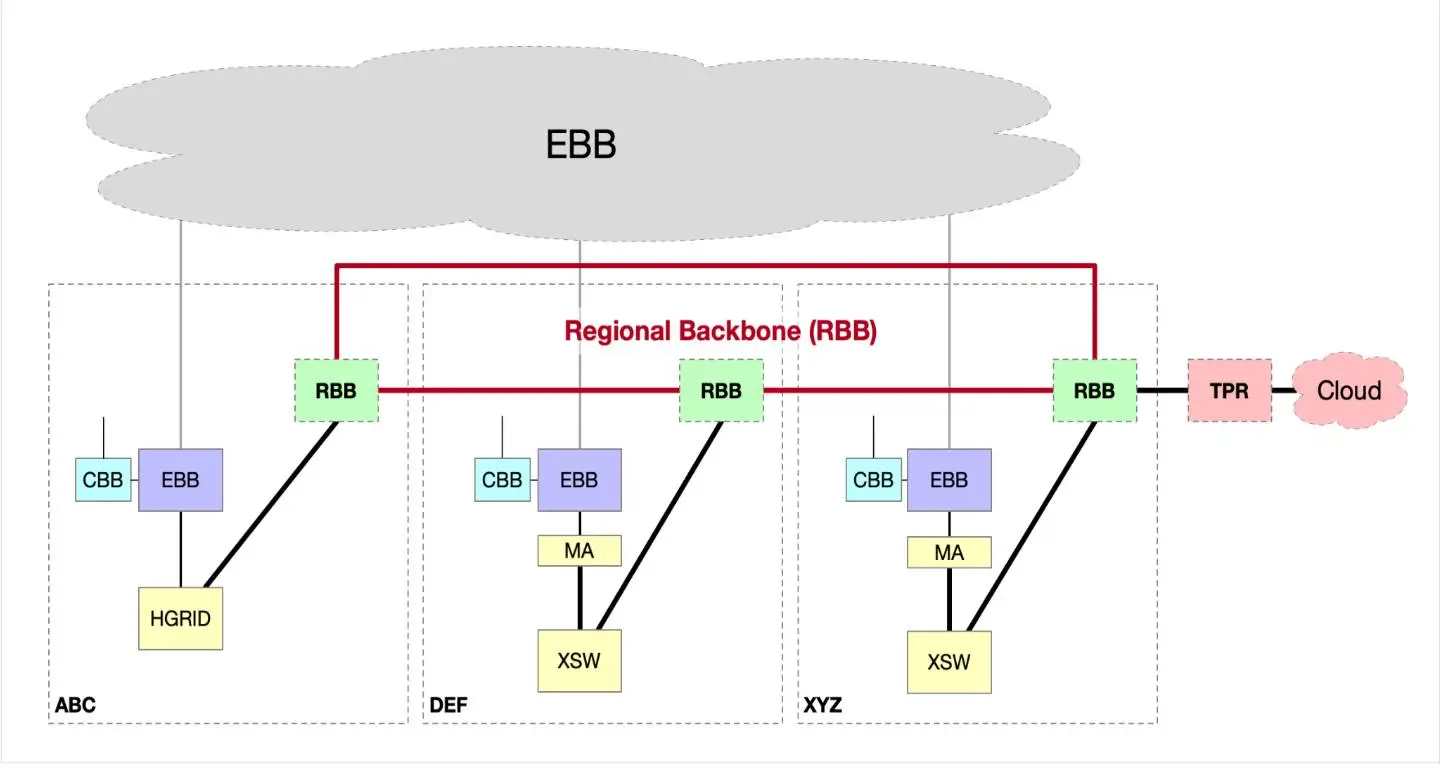
我们已使用FBOSS在区域骨干网络中部署了IPv6段路由(SRv6)。这为我们跨地域互联AI集群提供了更灵活的流量工程与更简化的运维——运行于CiscoSiliconOne驱动的开放浅缓冲交换平台之上,并持续将更多芯片家族纳入其中,全部通过FBOSS基于OCPSAI进行管理。
Meta的区域骨干网(RBB)将数据中心园区互连并连接到公共云容量。
面向Scale-Up的以太网:我们对以太网的承诺
OCP2026的一个标志性里程碑是证明**以太网能够胜任scale-up域**——即机柜或Pod内加速器之间那种传统上必须依赖专有技术的高带宽、超低时延互联。
###Tahan:基于以太网的Scale-Up交换机
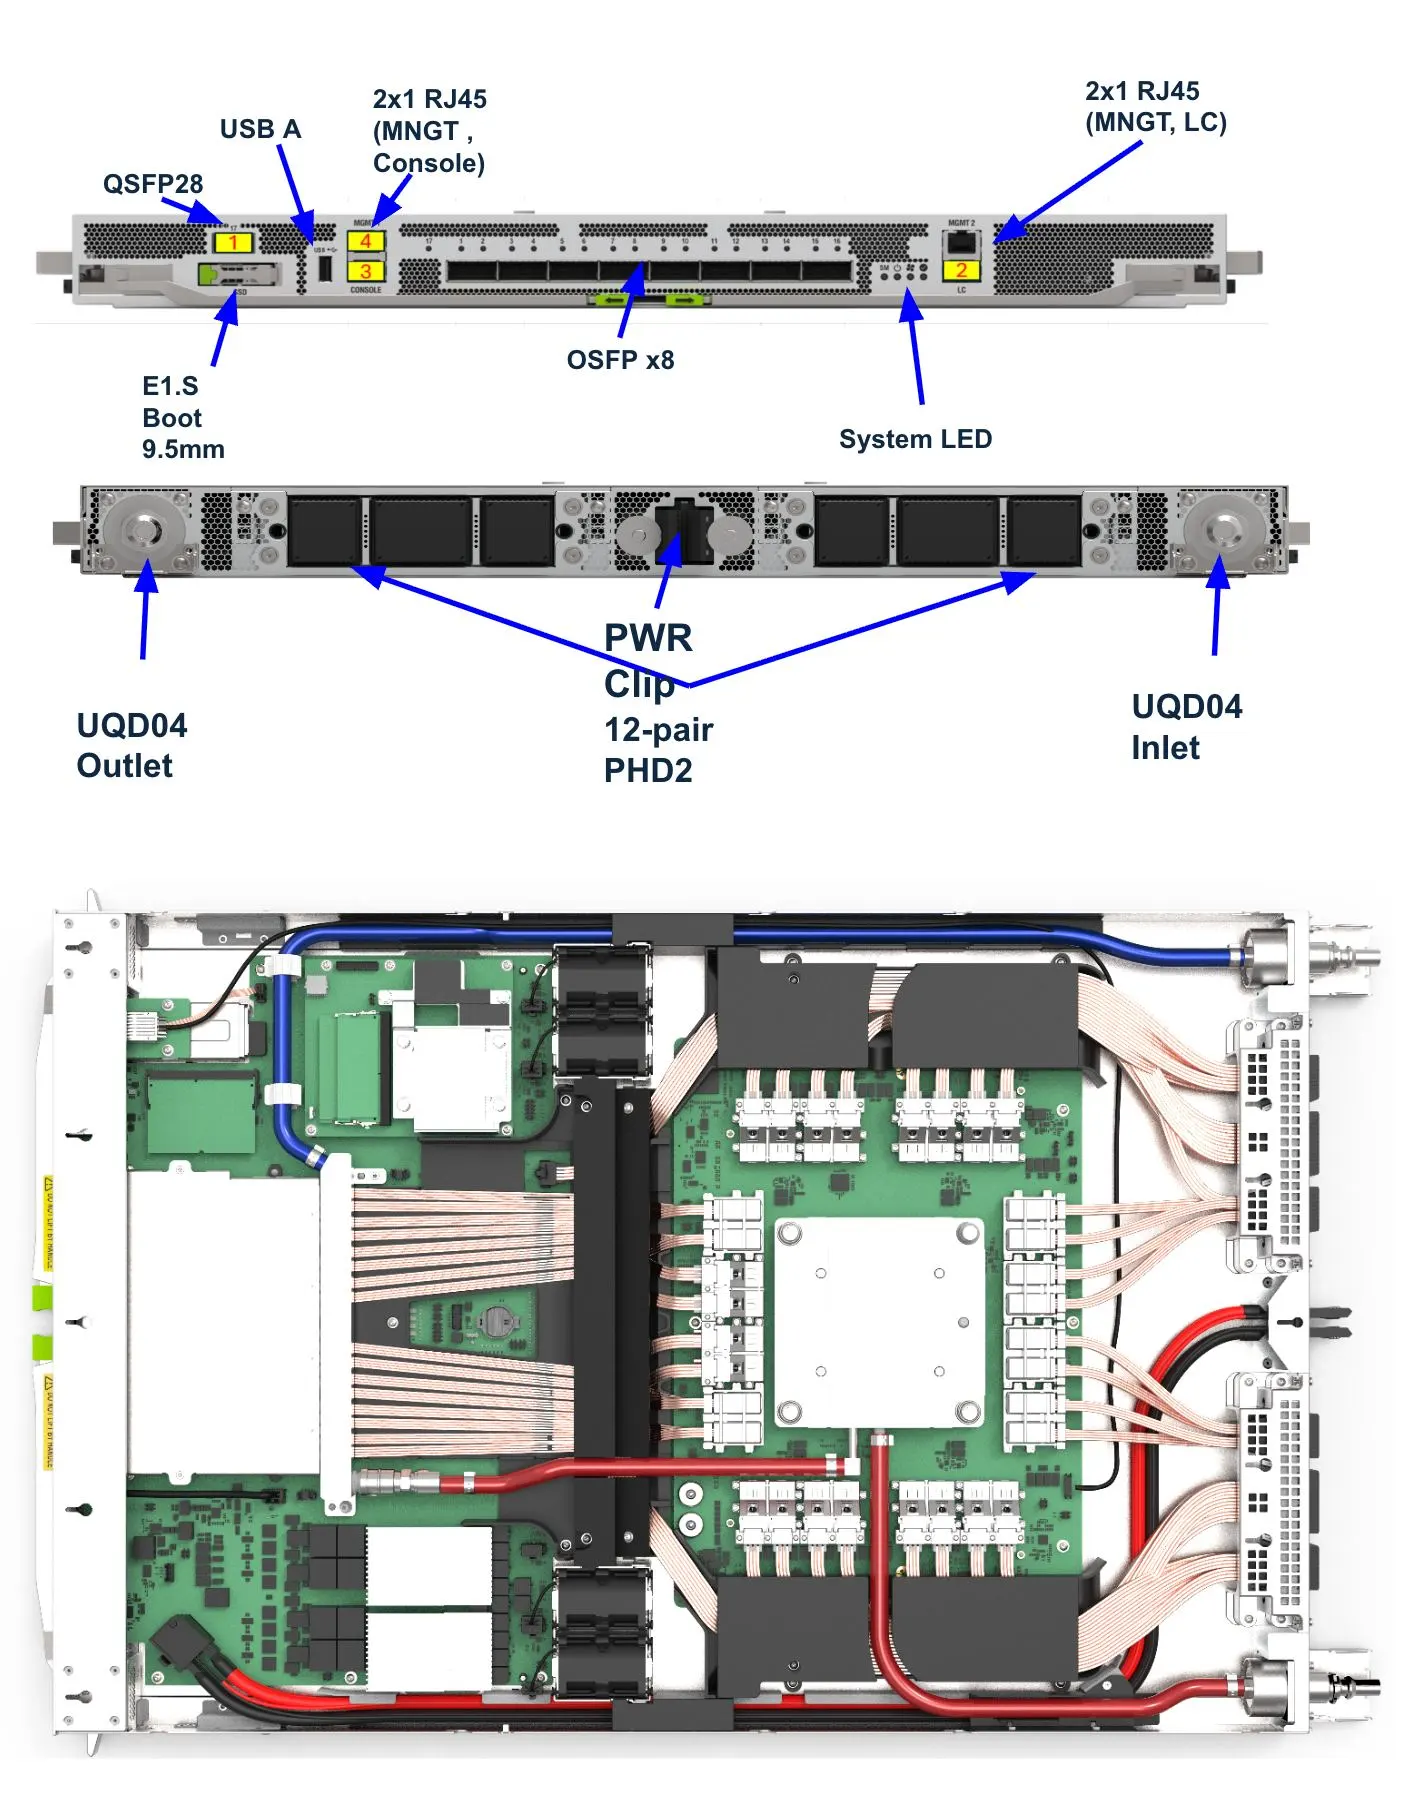
我们正式推出Tahan——Meta基于以太网的scale-up交换机,专为我们的MTIA300训练加速器打造。Tahan基于Broadcom51.2Tbps的Tomahawk5ASIC,总容量为64×800G,其中一半通过背板为加速器提供scale-up连接。四台Tahan交换机以无阻塞拓扑互联16个加速器。
重要的是,Tahan复用了与scale-out网络**相同的无损RoCE传输**(路由IPv6、PFC、AI调优QoS),从而在FBOSS之下统一了scale-up与scale-out两层网络。
Tahan,Meta的第一款开放式以太网扩展交换机(32×800G),采用液冷和运行FBOSS。
下一代Scale-Up:基于102.4T芯片的单机柜72加速器
我们还预览了下一代scale-up交换板——基于102.4TbpsBroadcomTomahawk6C芯片的216×400G交换机。八台此类交换机可互联**每机柜72个加速器**,这是102.4T世代带宽所带来的密度跃升。未来的scale-up交换板计划采用**OCP的ESUN(EthernetforScale-UpNetworking)作为scale-up数据平面**,进一步夯实我们对整个scale-up技术栈开放标准的承诺。
下一代MTIA纵向扩展刀片:采用OCPESUN作为纵向扩展数据平面,采用102.4Tbps芯片上的216×400G。
###ESUN的持续演进
我们去年在OCP内创立的ESUN倡议已取得重大进展。ESUN正与AMD、Arista、ARM、Broadcom、Cisco、HPE、Marvell、Microsoft与NVIDIA携手推进以下方面的开放规范:
-针对scale-up拓扑优化的协议头部与帧格式
-面向无损多跳网络的错误处理机制
-与UEC及IEEE标准的协同对齐
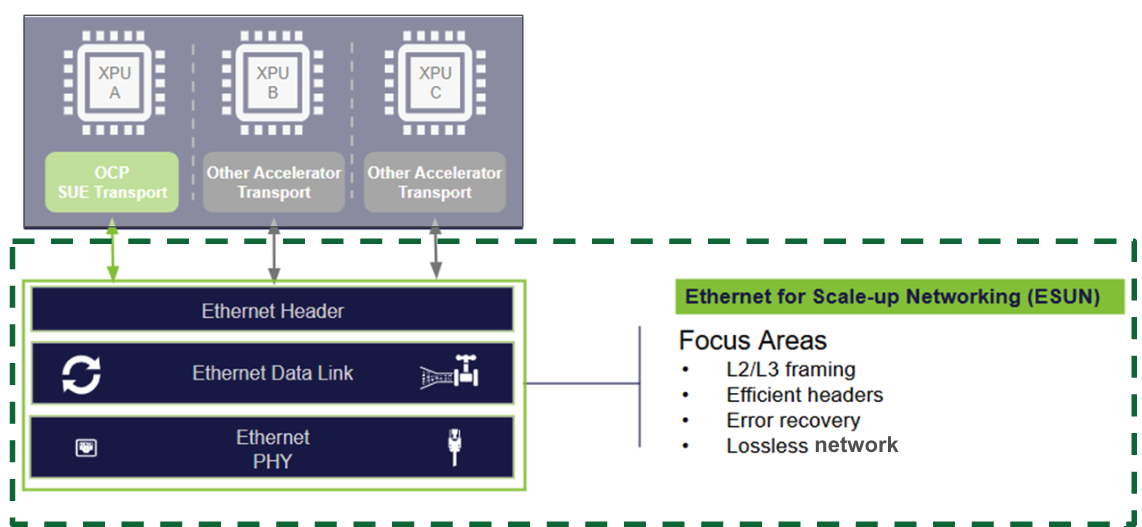
这项工作已产出具体成果:ESUN1.0《网络操作者需求基础规范》于今年早些时候发布。ESUN1.0有意**聚焦于网络本身**——定义网络必须交付什么,而将实现灵活性留给GPU与加速器厂商,从而扩大了适用范围。它还**与现有标准组织协同**,复用IEEE与超以太网联盟(UEC)正在进行的工作,而非重复造轮子。
自ESUN1.0发布以来,工作组已接近下一个版本ESUN1.1,着手解决交换机profile、包间间隔(inter-packetgap)缩减等新特性,进一步针对低时延scale-up场景优化以太网。
ESUN的技术重点:以结构为中心的范围,保持GPU实现的灵活性,与IEEE和UEC标准协调,与已经发布的ESUN1.0规范协同工作。
随着Tahan的正式出货、每机柜72加速器并将采用ESUN作为数据平面的设计提上日程、ESUN持续演进其开放规范,我们正在帮助构建面向scale-up未来的完整开放平台。
---
>原文:MetaEngineering(engineering.fb.com),发布于2026年10月12日
>作者:Meta网络基础设施团队(NetworkInfrastructureteamatMeta)
纽瑞德气体是专业特种气体服务商,主营高纯稀有气体、电子特气、标准混合气、同位素气体,包含氦气、氖气、氙气、六氟化硫等,纯度可达 5N 以上。配备专业检测设备,支持定制配气,可提供充装、危化品配送与技术支持。产品服务半导体、电力、光纤、航天科研等行业,为高端制造提供可靠特种气体配套。致电:17764012828
投稿与新闻线索:邮箱:tuijiancn88#163.com(请将#改成@)
特别声明:企业推荐网转载其他网站内容,出于传递更多信息而非盈利之目的,同时并不代表赞成其观点或证实其描述,内容仅供参考。版权归原作者所有,若有侵权,请联系我们删除。